如果每次出问题都要靠用户投诉才知道,说明可观测性还没建起来。趁系统健康时把它搭好,远比出事再补划算。
运维与安全工作的价值,常常体现在「什么都没发生」上。「用云监控搭建可观测体系:指标、日志、告警」所涉及的监控告警与可观测体系,正是这种隐性价值的来源:体系健全时风平浪静,体系缺失时一次小问题就可能演变成大事故。
三大支柱
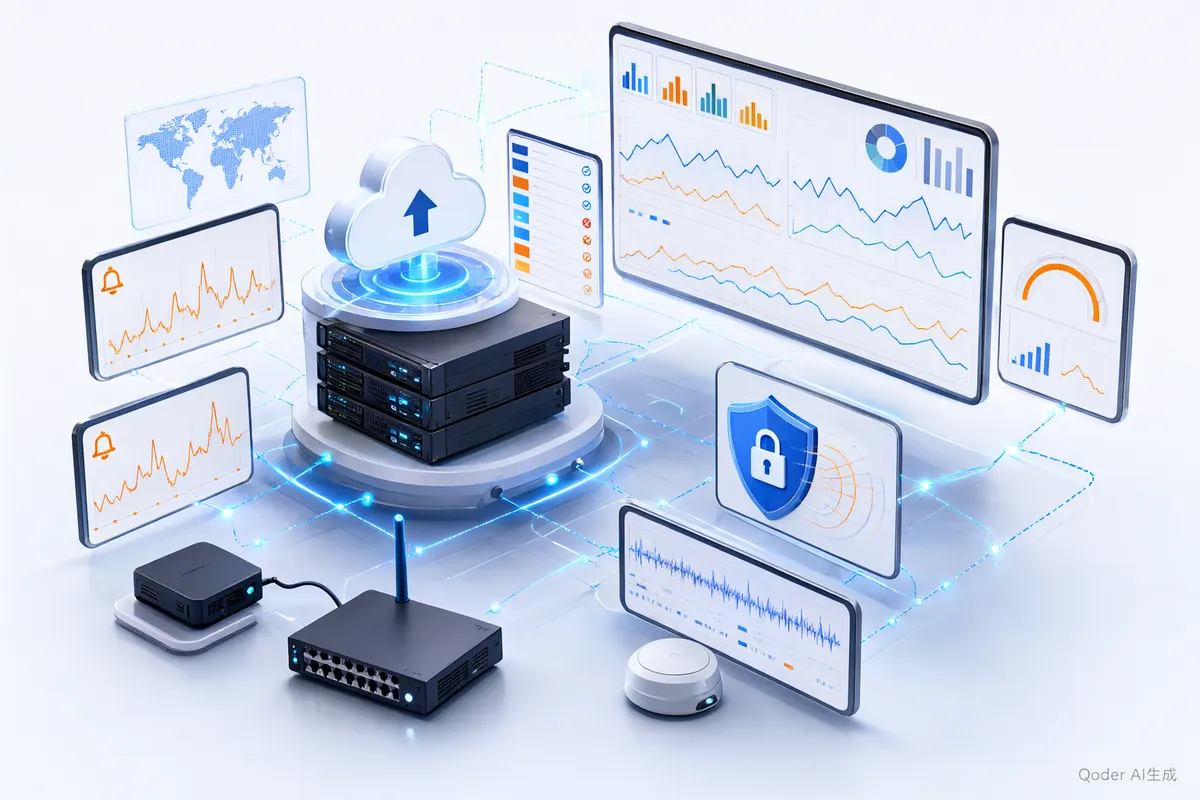
指标(Metrics)、日志(Logs)、链路追踪(Traces),三者缺一不可,分别回答"有没有问题、发生了什么、慢在哪一环"。
基础 + 自定义指标告警
CPU、内存、磁盘使用率与 IOPS、网络流量、TCP 连接数设阈值告警;关键业务补自定义指标,如 QPS、错误率、P99 时延。
日志集中化
用日志服务(SLS)统一收集系统日志与业务日志,配置关键字告警与查询仪表盘,别再一台台 SSH 上去 grep。
告警治理
告警要分级(P0 电话、P1 短信、P2 群消息),设置静默与聚合规则,避免告警风暴和"狼来了"导致的麻木。
健康大盘
建一个业务健康大盘,让值班同学一眼就能看清系统整体状态。
小结:可观测性建设要趁早,指标 + 日志 + 链路 + 分级告警,才能从"被动救火"转向"主动发现"。
指标分层与告警分级
指标不要一上来就追求全覆盖,先抓住四类黄金信号:延迟、流量、错误、饱和度。这四类覆盖住,绝大多数故障都能被及时发现;之后再逐层补业务指标(下单成功率、登录成功率、任务积压量)。
- 告警分级:P1 立即电话或短信通知并要求响应,P2 工作时间内处理,P3 进日报;不同级别配不同通知渠道与响应时限。
- 抑制派生告警:同一根因只保留最上游的一条告警,下游服务的连锁告警自动聚合,避免告警风暴淹没关键信息。
- 日志字段规范:统一时间、服务名、实例、请求标识、级别等字段,日志集中之后才查得动;否则只是把散乱搬到了同一个地方。
- 留存策略:按合规要求与排查需要设定日志留存周期,冷热分层存放,兼顾可查与成本。
每月做一次告警统计:长期无人处理或频繁误报的告警,要么调整阈值要么删除。目标是让团队形成共识——告警响了就该有人动,而不是习惯性地静音。
一份可执行的日常清单
- 暴露面盘点:定期梳理对外端口与服务,关闭不必要的开放。
- 权限最小化:账号与密钥按最小权限分配,定期回收闲置权限。
- 告警治理:清理长期无人响应的告警,保证留下的告警都值得处理。
- 预案演练:对高频故障场景准备处置预案并定期演练。
清单不复杂,难在坚持;而监控告警与可观测体系的差距,恰恰体现在坚持上。
把监控告警与可观测体系交给更专业的协作方
安徽卓牛为客户提供云上的安全加固、监控体系搭建与运维托管服务,能够结合阿里云安全与可观测产品,帮助团队建立可持续的运维安全体系,而非一次性整改。
若你希望就「用云监控搭建可观测体系:指标、日志、告警」涉及的内容做一次现状评估,可通过官网在线客服联系安徽卓牛,获取针对性建议。