负载均衡如果配置不当,故障时流量还在往已经挂掉的后端打,等于白配。这里总结选型与健康检查的关键实践。
在讨论「SLB / ALB 选型与健康检查最佳实践」时,真正决定成败的往往不是某个单点配置,而是把负载均衡与流量调度放进整体架构之后的一致性设计。资源规格、网络边界、弹性策略与故障域需要放在一起权衡,任何一环脱节,都会在流量高峰或故障切换时被成倍放大。
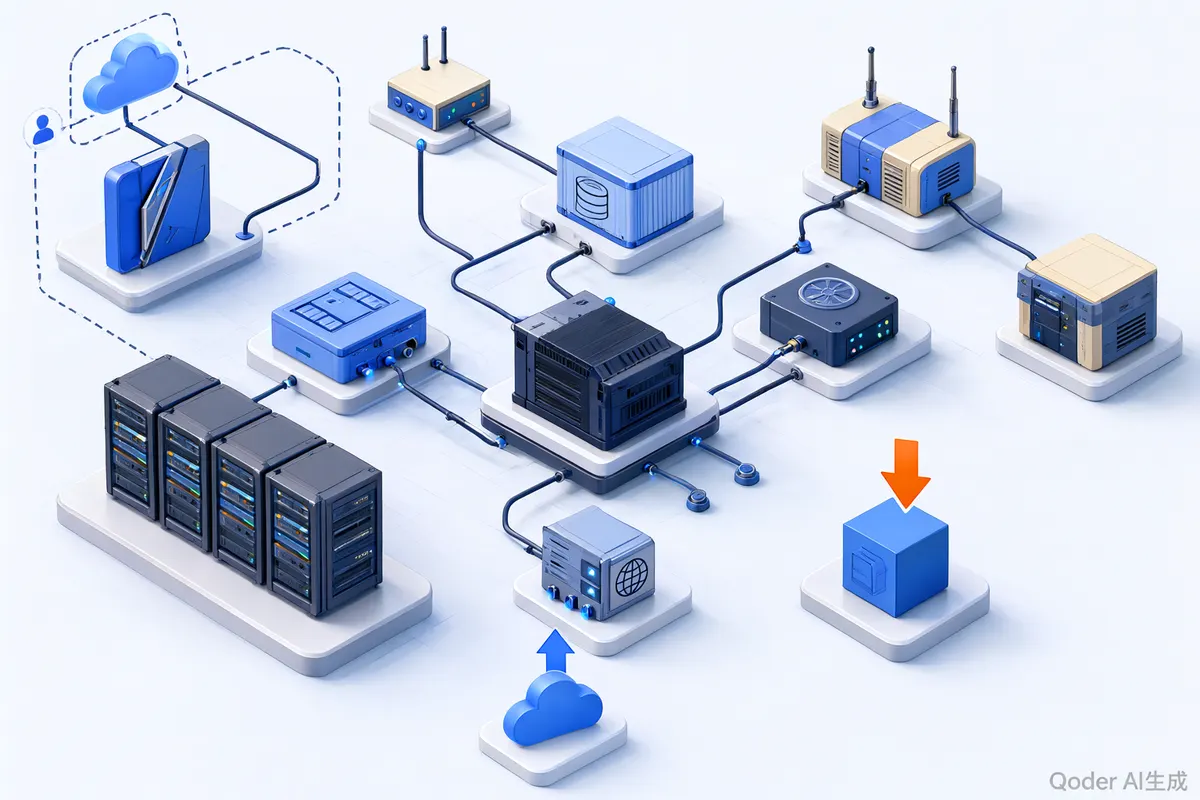
选型
- 四层(TCP/UDP)、追求超大并发与低延迟:选 NLB / CLB。
- 七层(HTTP/HTTPS),需要按内容路由、gRPC、WebSocket:选 ALB。
健康检查要检查"真健康"
健康检查应指向能真实反映业务与依赖状态的端点(比如会检查数据库连通性的 /health),而不是仅仅探测 TCP 端口是否通。合理设置检查间隔、超时与健康 / 不健康阈值,避免网络抖动导致节点被误摘或误挂。
会话保持
无状态应用尽量不要开会话保持;确实需要时,选择合适的 cookie 策略与超时时间。
优雅上下线
发布时结合健康检查做优雅摘除:先把节点从负载均衡摘掉、等存量请求处理完,再停机,避免发布期报错。
HTTPS 卸载
在 ALB / CLB 上卸载 TLS,后端走 HTTP,既减轻后端计算压力,又便于集中管理证书。
小结:健康检查配置是负载均衡可靠性的关键,务必贴合真实业务健康,而非仅探端口。
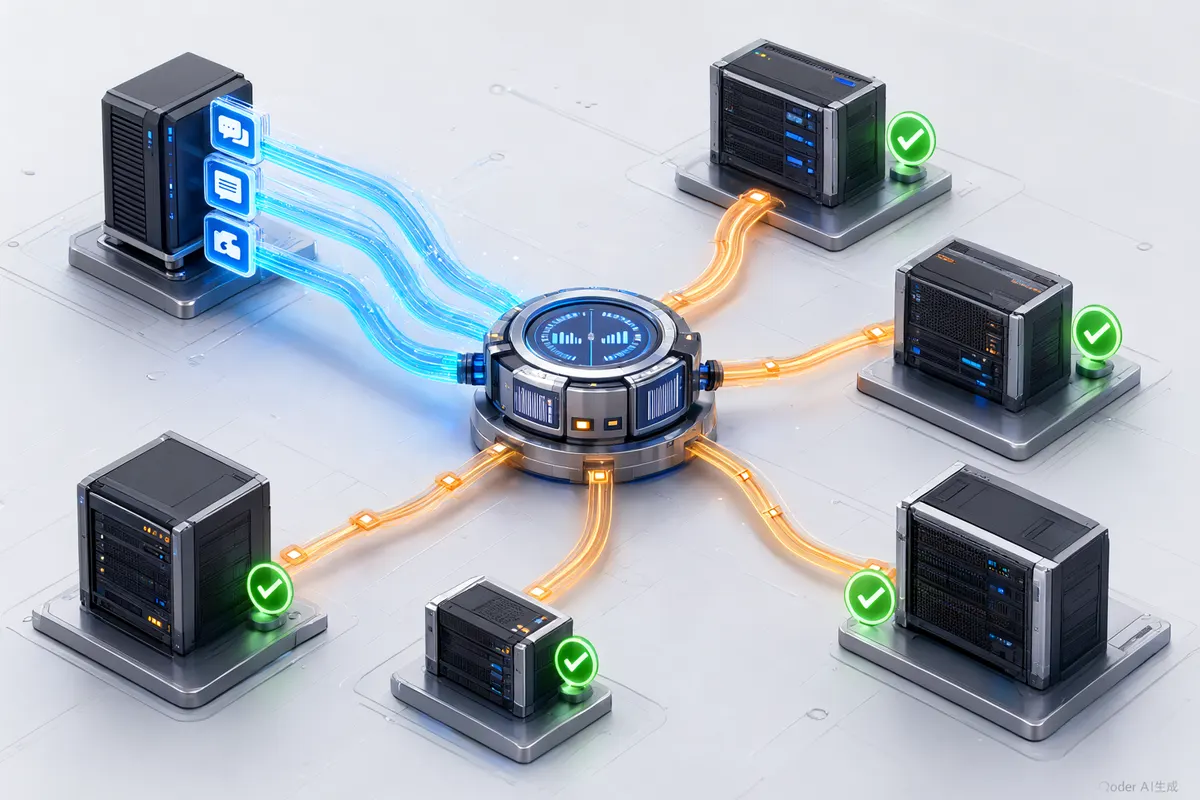
优雅上下线要走完整条链路
发布期间出现零星 5xx,多半不是负载均衡的问题,而是上下线链路缺了某一环。健康检查摘除、连接排空、应用处理停止信号、就绪探针,四者缺一不可。
- 摘除在前:先让负载均衡把实例判为不健康并停止分发新请求,再开始停止应用,顺序颠倒就会丢请求。
- 排空存量:等待已有连接处理完成(配置连接排空或应用侧的优雅退出超时),不要立即强制结束进程。
- 应用侧配合:收到停止信号后关闭监听、处理完存量请求再退出;启动时就绪探针通过后才接流量。
- 分批发布:保证任意时刻有足够健康后端承载流量,避免一次性摘除过多实例。
还要提前验证跨可用区的容错能力:当某个可用区的后端全部不可用时,流量是否能自动分发到其他可用区,健康检查与后端分布是否支持这种切换。这类能力要在演练中确认,而不是等真实故障时才知道。
把负载均衡与流量调度放回架构全局来看
单点的最优解,叠加起来未必是全局最优。评估负载均衡与流量调度时,建议先明确业务的峰值模型与故障容忍度,再倒推资源与网络该怎么设计:哪些负载是稳定基线、哪些是突发流量、哪些可以容忍短暂中断,答案不同,架构取向也完全不同。
在此基础上再谈规格与参数,才有意义。否则很容易陷入「先买资源、再找用途」的被动局面,成本与复杂度都会随之上升。
落地前的自检清单
- 容量与规格:是否用真实压测数据而非经验估算来定规格,是否预留了弹性空间。
- 网络与边界:网段划分是否留有扩展余地,安全组是否遵循最小开放原则。
- 弹性与容灾:扩缩容策略是否经过演练,故障切换路径是否清晰、可回退。
- 可观测性:关键链路是否有指标、日志与告警覆盖,出问题能否快速定位。
这四件事做到位,负载均衡与流量调度才算真正「落地」,而不是停留在方案文档里。