很多企业 RAG 效果差,问题往往不在模型,而在"检索到的内容不对"。RAG 是检索质量决定上限、生成决定体验。
大模型应用走到今天,「能不能跑通」早已不是问题,「能不能稳定地产生业务价值」才是。「企业 RAG 落地:文档切分与召回质量调优」讨论的RAG 知识库与召回质量,正处在这个从演示走向生产的关键阶段,工程化能力比模型参数更决定最终效果。
文档解析
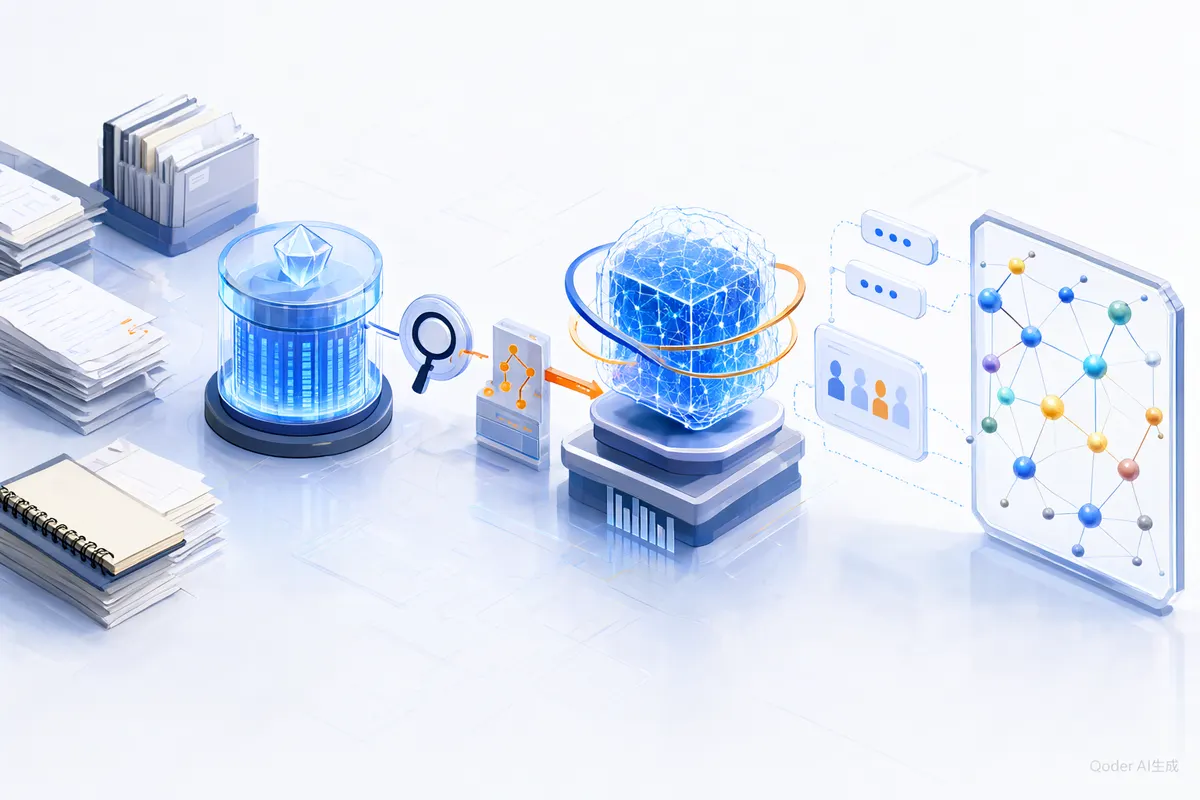
先解决 PDF、表格、图片的结构化解析,保留标题层级与语义边界。脏数据进,就一定脏答案出。
切分策略
按语义 / 段落切分优于固定字数;块大小与重叠要调(常见几百 token + 少量 overlap);给每个块附加标题、来源等元数据,便于召回和溯源。
向量化与检索
选择合适的 embedding 模型;用"向量检索 + 关键词(BM25)"的混合召回,通常比纯向量更稳,尤其对专有名词和精确匹配。
重排(rerank)
对召回结果做 rerank,再取 Top K 喂给模型,能显著提升进入上下文内容的相关性。
生成与溯源
在 prompt 里明确"只依据给定资料回答、无依据则如实说不知道",并返回引用来源,降低幻觉。
评估
建立评测集,量化召回率、命中率与答案质量,用数据驱动调参,而不是拍脑袋改配置。
小结:把功夫下在文档切分、混合召回与重排上,RAG 的效果会有质的提升。
先建评估集,再动切分与召回参数
RAG 调优最容易陷入的循环是:改一个参数、试几个问题、感觉变好了、上线、被用户投诉。缺少评估集时,每次改动都是不可验证的赌注,甚至可能在修好一类问题的同时弄坏了另一类。
- 评估集的构成:收集真实业务问题,为每个问题标注标准答案要点,以及应该被召回的文档片段。样本要覆盖高频问题、边界问题,以及知识库中确实没有答案的问题。
- 分层指标:召回层看目标片段是否进入结果集、排名是否靠前;生成层看答案是否覆盖要点、是否忠于原文、是否在没有依据时明确说不知道。两层分开看,才能判断问题出在检索还是生成。
- 参数逐项验证:块大小、重叠长度、召回数量、重排开关,一次只改一项并记录指标变化,形成可回溯的调参记录,避免多变量同时调整导致无法归因。
- 知识库同步机制:文档更新后要及时重新解析与索引,并保留版本与生效时间。回答涉及政策、流程、报价口径时,出处的时效性比答案本身更重要。
- 坏例回流:把线上答错或被用户纠正的问题定期回流到评估集,让评估集随业务一起成长,这比一次性构建更有长期价值。
有了评估集之后,还可以用它来做选型对比:不同的切分策略、向量化模型与重排方案,谁更合适由数据说话,而不是由演示效果说话。评估集也是团队协作的基础,新人改动能立刻看到影响,讨论才有共同的事实依据。
RAG 知识库与召回质量落地的常见断层
演示环境里效果惊艳、上线之后表现平平,是RAG 知识库与召回质量最常见的落差。原因通常不在模型本身,而在于上下文质量、检索召回、提示词稳定性与评估体系的缺失。把这些工程环节补齐,效果往往比更换模型更明显。
因此建议把评估前置:先定义什么叫「好」,再谈优化手段,避免在缺乏度量的情况下反复试错。
一条稳妥的推进路径
- 小场景切入:选择容错度高、价值清晰的场景先跑通闭环。
- 建立评估集:用真实业务样本构造评测集,让每次改动可对比。
- 控制上下文成本:按需裁剪上下文、缓存重复请求,兼顾效果与开销。
- 人机协同兜底:关键输出保留人工复核通道,逐步放大自动化比例。
这条路径不追求一步到位,但能显著降低RAG 知识库与召回质量的落地风险。